自律型AIエージェントやAIエディタ「Cursor」が普及する中、開発現場のテックリードを悩ませているのが「フロンティアモデルの従量課金に伴うAPI費用の急騰」です。複数ブランチでの並列リファクタリングやテスト自動生成ループを回せば、1タスクあたり数百円から数千円が消費され、開発効率化の恩恵がクラウド費用に相殺される事態が生じています。
こうした状況下、2026年7月9日に一般公開された「Grok 4.5」は、入力100万トークンあたり$2.00、出力$6.00という低価格と「Claude Opus級」を掲げる性能で脚光を浴びています。特に開発パートナーであるCursorの基盤モデルプールに統合されたことで、日常的なエディタ作業からCI/CDパイプラインまでを一新するモデルとして期待されています。
しかし、SNS上の「Claude完全置換」といった極論を鵜呑みにするのは危険です。公式実測値を精査すると、絶対精度では最上位モデルに及ばない現実や、前世代より短いコンテキスト長、ベンチマーク汚染の開示、EU未提供という法的な利用制約が浮き彫りになります。
本稿では、Cursorを活用するWeb・SaaS開発企業のテックリードに向けて、一次情報と実動作仕様をベースにGrok 4.5の実力を徹底解剖します。SWE-Bench Proで実証されたトークン消費効率のメカニズム、エディタ上でのFastバリアントの使い分け、企業導入を阻む構造的リスクを工学的視点から解説します。
【3秒でわかる結論:Grok 4.5の実力値と導入判断】
・性能水準: Claude Opus 4.8と2勝2敗の互角、Claude Fable 5には全敗。「Opus超え」ではなく「Opus級」が正確な評価
・最大の武器: SWE-Bench Proで実証された「出力トークン約4.2分の1」×「出力単価約4.2分の1」による約17.5倍の実質コスト削減
・運用上の注意: コンテキスト長は前世代(1M)から500Kへ半減。CursorBenchへの過去コード混入開示、EU未提供の制約を前提に設計が必要
開発元「SpaceXAI」への再編とCursor買収がもたらした開発背景
Grok 4.5の立ち位置を理解するには、組織再編とインフラ統合の背景を押さえる必要があります。
旧xAIの開発体制は、2026年2月にSpaceXによる全株式交換(約1.25兆ドル規模)を通じた非公開合併を経て、2026年7月6日に「SpaceXAI」へ正式リブランドされました。さらに同社は2026年6月、Cursor開発元のAnysphere社を600億ドルの全株式取引で買収することを発表し、計算資源(スーパーコンピュータColossus等)と開発者インターフェースを垂直統合しました。
Grok 4.5はSpaceXAIリブランド後の第一弾フロンティアモデルです。何より重要なのは、本モデルがCursor利用現場から得られた数兆トークン規模の実操作ログを用いて共同学習された点です。インライン補完や差分差し戻しといった「現場のリアルな開発行動データ」が重みに焼き付けられており、これが驚異的なトークン消費効率を生み出す根源となっています。
公開ベンチマーク全4本の実測値検証:「Opus級」の真偽と2勝2敗の内訳
開発元が公開した公式ベンチマーク比較表(2026年7月公表)には、主要モデルとの4本の標準テスト結果が明記されています。
開発元公表のベンチマーク実測数値:
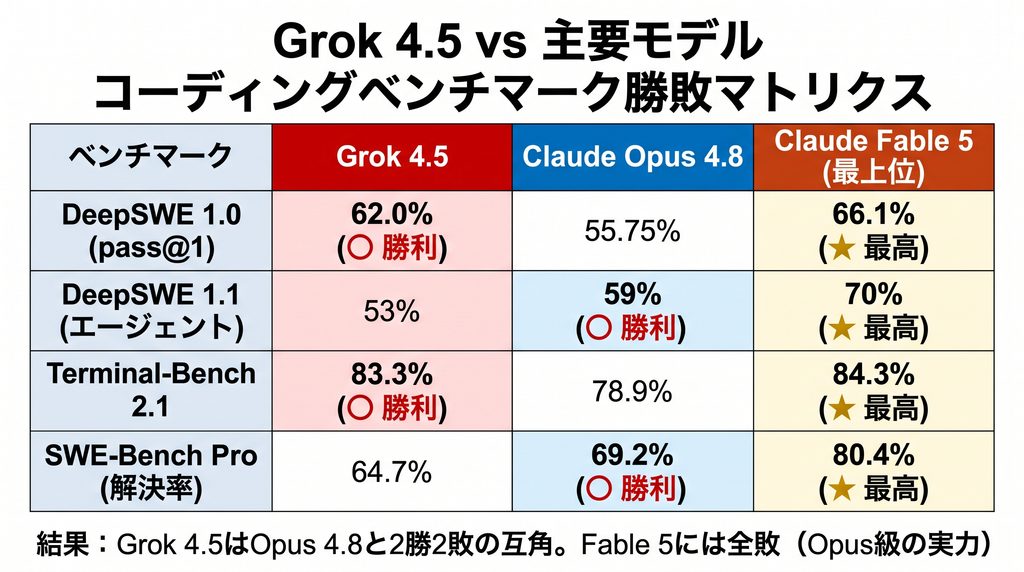
・DeepSWE 1.0 (pass@1): Grok 4.5 [62.0%] vs Claude Opus 4.8 [55.75%] vs Claude Fable 5 [66.1%]
・DeepSWE 1.1 (mini-swe-agent): Grok 4.5 [53%] vs Claude Opus 4.8 [59%] vs Claude Fable 5 [70%]
・Terminal-Bench 2.1: Grok 4.5 [83.3%] vs Claude Opus 4.8 [78.9%] vs Claude Fable 5 [84.3%]
・SWE-Bench Pro(解決率): Grok 4.5 [64.7%] vs Claude Opus 4.8 [69.2%] vs Claude Fable 5 [80.4%]
出典:SpaceXAI Developer Docs(2026年7月公開)
数値と工程の客観的解釈:互角の2勝2敗
開示数値を分析すると、「Claude Opus超え」という言説は事実に反します。
Grok 4.5がClaude Opus 4.8(max推論)を上回ったのは、DeepSWE 1.0(62.0%対55.75%)とTerminal-Bench 2.1(83.3%対78.9%)の2本です。一方、DeepSWE 1.1(53%対59%)とSWE-Bench Pro(64.7%対69.2%)の2本では下回っています。4戦2勝2敗の互角であり、「Opus級」という表現は同等性能ティアを示す意味では妥当ですが、Opusを全面的に凌駕したわけではありません。
さらに、フラッグシップのClaude Fable 5(2026年6月発表)と比較すると、全4本でGrok 4.5は敗北しています。特に実務の複雑な課題解決力を測るSWE-Bench Proでは、Fable 5の80.4%に対しGrok 4.5は64.7%と、15.7ポイントの明確な性能差が存在します。
アナリスト見解:自社開示姿勢とCursorBench汚染の真実
評価すべきは、自社が首位を取れていないデータを含め、他社上位モデルとの差をありのまま公開している透明性です。
ただし、Cursorユーザーが絶対に警戒すべきは、「CursorBenchにおける学習データ混入(ベンチマーク汚染)」の自己開示です。Cursor公式ブログにて、「Grok 4.5の事前学習データセットにCursor自体の過去コードベースが誤混入し、CursorBenchで有利な結果が出ている」と公表されています。Cursor環境でのスコアには下駄が履かされている状態であり、汎用能力を判断する際は、汚染が開示されていないSWE-Bench Pro等の数値を評価の主軸に据えるべきです。
SWE-Bench Proで実証されたトークン効率:同一タスクで約17倍のコスト差が生じる構造
Grok 4.5の真価は、ベンチマーク勝敗ではなく「課題解決に要する出力トークン数の少なさ」と「低単価」がもたらす圧倒的なコスト効率にあります。
| モデル名 | 入力単価(/1M) | 出力単価(/1M) | SWE-Bench Pro 平均出力トークン数 | 1タスクあたりの出力コスト試算 | 対Grokコスト比 |
|---|---|---|---|---|---|
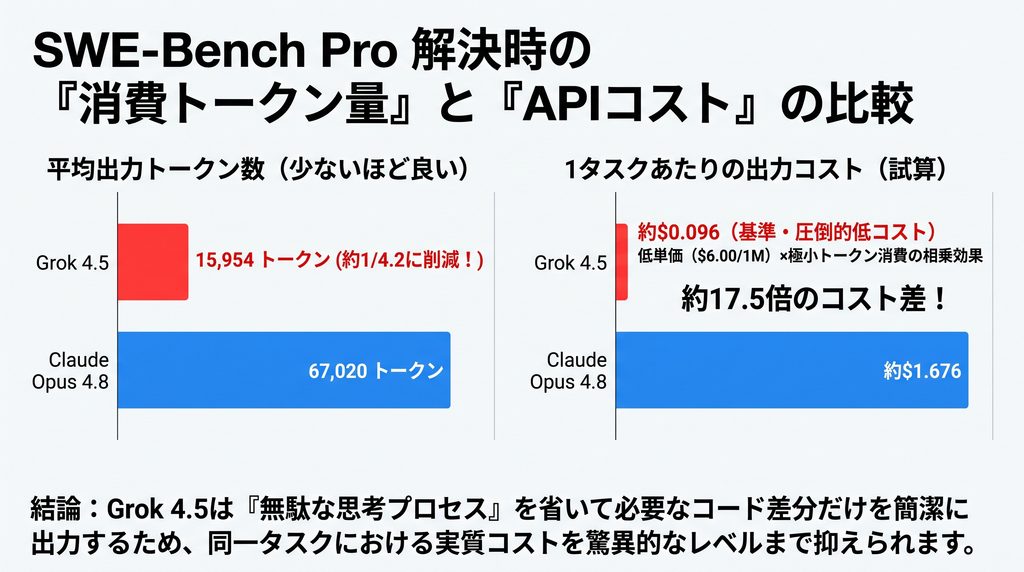
| Grok 4.5 | $2.00 | $6.00 | 15,954トークン | 約$0.096 | 基準(1.0倍) |
| Claude Opus 4.8 (max) | $5.00 | $25.00 | 67,020トークン | 約$1.676 | 約17.5倍 |
| Claude Fable 5 (max) | $10.00 | $50.00 | 高水準(推定) | 推定$2.00以上 | 約20倍以上 |
数値と工程の解釈:トークン消費量と単価の二重削減
SWE-Bench Proの実測において、Claude Opus 4.8が1タスク完了に平均67,020トークンを出力したのに対し、Grok 4.5はわずか15,954トークンで完了しています。消費量は約4.2分の1です。
ここにAPI出力単価の差が乗算されます。Grok 4.5の出力単価($6.00/1M)はOpus 4.8($25.00/1M)の約4.2分の1です。「出力トークン数が4.2分の1」×「出力単価が4.2分の1」の掛け算により、1タスク解決の実質出力コストは約$0.096対約$1.676となり、約17.5倍のコスト格差が生じます。
アナリスト見解:冗長な思考プロセスの排除と適用業務の切り分け
このトークン差の要因は、近年のモデルが過剰な内部対話を出力しがちなのに対し、Grok 4.5はCursorデータ学習により「コード修正に必要な差分だけを簡潔に出力する」挙動が徹底されているためです。
この工学的特性から、現場での合理的な使い分け基準は次の通り整理できます。
- 大量反復型エージェントループ: バックグラウンドで試行錯誤を繰り返すタスクでは、トークン効率と単価が月間コストを左右するためGrok 4.5が圧倒的に有利。
- CI/CDの自動テスト修正: 仕様が明確な定型タスクではGrok 4.5の費用対効果が最大化される。
- 本番障害対応や基幹リファクタリング: 1回の推論失敗が致命傷になる領域では、17倍のコストを払ってでも80.4%の精度を誇るClaude Fable 5を選ぶべきです。
Cursor環境における実運用:通常版とFastバリアントの使い分け
Cursor有料プランではファーストパーティモデルとしてGrok 4.5を利用できますが、エディタ運用には落とし穴があります。
| バリアント名 | 入力単価(/1M) | 出力単価(/1M) | 特徴と実務上の用途 |
|---|---|---|---|
| Grok 4.5(通常版) | $2.00 | $6.00 | スループット約80 TPS。バッチ処理、エージェント向け |
| Grok 4.5 Fast | $4.00 | $18.00 | 低レイテンシ特化。チャットでの対話的コーディング向け |
Fast版の出力単価は$18.00/1Mで、通常版の3倍です。対話型コーディングでは初速が重要なためFastを選ぶ価値がありますが、AgentモードでFastを長時間走らせるとコスト優位性が消失します。対話にはFast、自動スクリプトには通常版を指定する運用ルールが必要です。また、キャッシュ活用には prompt_cache_key の固定が必須です。
企業導入を阻む3つの実務的障壁と運用設計の条件
全社導入を検討する前に合意すべき3つの制約を解説します。
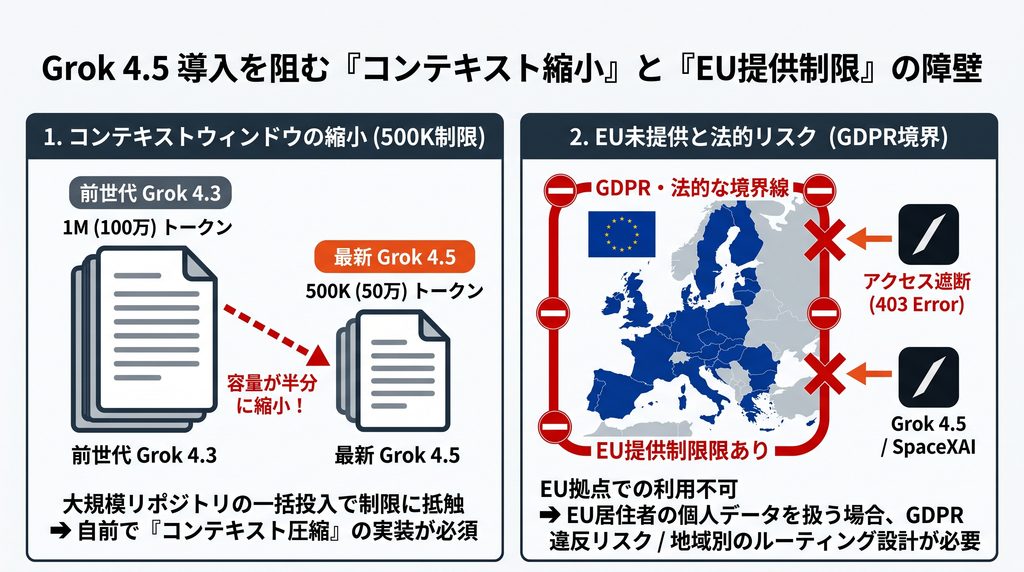
- コンテキストの縮小(500K制限): 正規仕様は500Kトークンです(パラメータ数は非公表)。前世代Grok 4.3(1M)から半減しているため、大規模リポジトリの一括投入では制限に抵触します。コンテキスト圧縮の自前実装が前提です。
- EU未提供に伴うGDPR等の制限: 2026年7月9日時点でEU向けには提供されていません。EU域内に拠点や委託先を抱える場合、現地の利用不可やDPA未締結によるGDPR違反リスクを負います。
- セーフガード緩和設計への自前対策: SpaceXAIは出力制限を他社より意図的に緩やかに設計しています。顧客接点や社内ボットに配置する場合、出力層に外部モデレーションAPI等の自前ガードレール設計が必須です。
開発現場への定着ロードマップ:PoCから実務導入までの5ステップ
- Day 1: namespace確保とAPIキー制限: 組織アカウントで専用キーを発行し、月額上限を設定してコスト暴走を防止。
- Day 2: Cursorでの通常版とFast版の検証: パイロット環境でレイテンシと体感精度を比較し、使い分けルールを策定。
- Day 3: 非重要リポジトリでのCI/CD検証: 定型テスト生成等にAPIを組み込み、Claude Opus比でのコスト削減率を観測。
- Day 4: コンテキスト圧縮処理の実装: 500K上限下で長時間のループを回すため、実行ログの要約圧縮アルゴリズムを検証。
- Day 5: セキュリティ監査と段階展開: EUデータの非通過とモデレーションフィルタを確認し、本番パイプラインへ適用。
実務で直面するつまずきと対策(トラブルシューティング)
- エージェントループが500K上限で突如停止する: スライディングウィンドウ方式を導入し、直近ログと要約テキストを分離してください。
- Cursor経由で想定より早くクォータを消費した: AgentモードでFast版が選択されていないか確認し、通常版を明示指定してください。
- プロンプトキャッシュがヒットしない: ヘッダーに
prompt_cache_keyを明示指定し、静的プロンプトに同一キーを付与してください。 - 生成コードに古い構文が混入する: 指示ファイル(CLAUDE.mdや.cursorrules)に最新バージョンと禁止構文を明記してください。
- EU拠点の開発メンバーでAPIエラーが発生する: 2026年7月時点でEUは未提供のため、EU拠点には他社モデルをフォールバックに設定してください。
よくある質問(FAQ)
Q1. Grok 4.5はClaude Opus 4.8を超えましたか?
超えていません。公式ベンチマーク4本ではOpus 4.8と2勝2敗の互角で、Claude Fable 5には全敗しています。真の価値は最高精度ではなく、Opus同等の推論を約4分の1のトークン消費量と4分の1以下の出力単価で実行できるコスト効率にあります。
Q2. コンテキスト長が1Mや2Mという情報は誤りですか?
誤りです。正規仕様は500Kトークンです。1MはGrok 4.3、2MはGrok 4 Fastの仕様です。長大ファイル群の処理では旧モデルとの使い分けが必要です。
Q3. CursorBenchでの高スコアは信頼できますか?
割り引いて評価する必要があります。Grok 4.5の事前学習データにCursor過去コードが混入した汚染が開示されているためです。汎用能力の判断にはSWE-Bench Pro等の数値を参照してください。
参考文献
- SpaceXAI, “Grok 4.5 Release Notes & Model Specifications”, 2026年7月公表
- SpaceXAI Developer Platform, “API Reference & Pricing Schedules”, 2026年7月公表
- Cursor (Anysphere), “Grok 4.5 Integration & Benchmark Contamination Disclosure”, 2026年7月公表
- Anthropic, “Claude Fable 5 and Claude Opus 4.8 Performance Evaluations”, 2026年6月公表

コメント